mola
大模型拥有万亿参数,但依旧需要最新的资料支持。庞大的互联网充满了各种低质资源、过时信息与大量噪声,以及与你真正要解决的问题无关的内容,结合 MolaGPT 在三年来运营的过程中得到的经验和内部的 Benchmark,今天推出 MolaGPT Web Search.
MolaGPT Web Search 会根据问题寻找合适的来源,把文字、图片和网页阅读结合起来,让搜索可以更直接地帮助我们完成手头的事情。你可以像平时一样向 MolaGPT 提问。查最新消息、找专业资料、整理旅行攻略,或者直接上传一张想了解的照片,搜索会随着问题自然展开。
更合适的信息来源
对一次搜索来说,找到相关网页只是开始。资料是否适合当前的问题,是否来自我们真正需要的网站,同样影响最后的回答。
比如,用户用中文去了解一个陌生的研究方向,中文综述有助于先建立概念框架,而英文论文则能进一步补充前沿进展;去查某个软件或开源库的用法,项目的官方文档和代码仓库通常比泛泛而谈的二手介绍直接得多。为此,MolaGPT Web Search 会结合问题的语言、领域特征和图片需求,动态选择相应的检索来源。
MolaGPT Web Search 整合了多种搜索服务提供商,分别用于中文资料、英文与技术信息、图文与视觉检索,以及地域和研究场景,它们在 MolaGPT 生态内共同提供搜索能力。
我们内部的 Benchmark 结果显示,单一搜索服务商在跨语言场景下往往存在明显的偏科现象,在 39 道中文查询与 17 道英文查询的选源测试中,偏中文生态的 Provider A(64%)、Provider B(56%)和通用型的 Provider D(56%)在中文里表现尚可,但使用英文关键词查询后,前三条结果的目标来源命中率分别下降到了 53%、35% 和 53%;反过来,Provider C 在英文查询里能拿到 82% 的高分,到了中文查询却只有 51%。
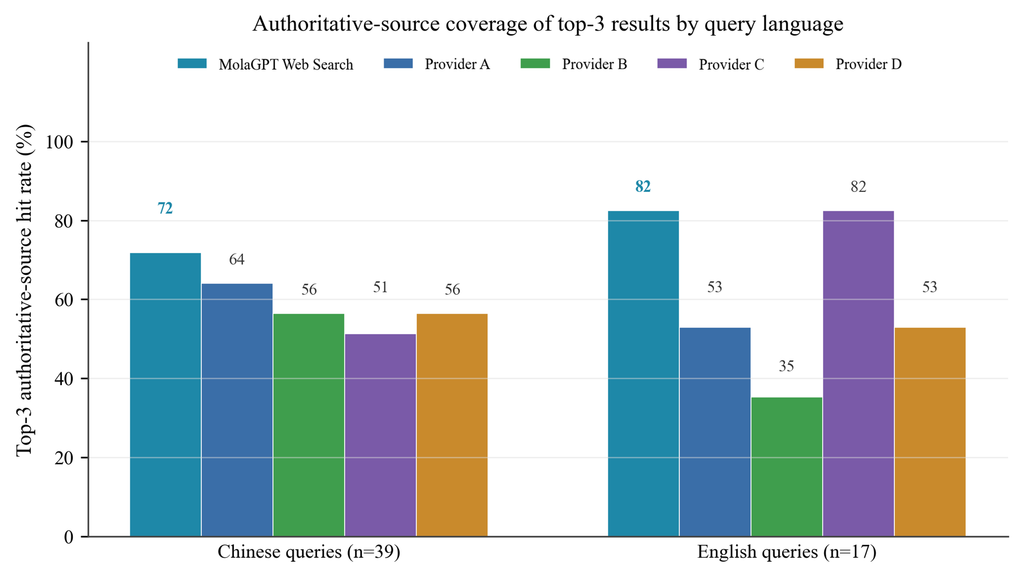
在中文(39 道)与英文(17 道)查询中,前三条结果的目标来源名单覆盖结果。
MolaGPT Web Search 把这些能力收拢在同一个入口里:在中文查询上我们取得了 72% 的目标来源覆盖率,超过了所有单一搜索源,同时在英文查询上保持了 82% 的最高水准。
为了测试这套系统在真实复杂场景下的端到端表现,我的 Benchmark 还整理了 60 道更具体的测试题,涵盖公司财报、政策法规、技术文档、学术论文、公共服务,以及专门用来测试抗干扰能力的“带有错误前提的问题”。在评测前,我人工查阅了对应的官方文件、原始论文和项目文档作为基准的预期答案,再逐条核对各家搜索实际返回的材料。
我们内部的 Benchmark 结果显示,MolaGPT Web Search 在 60 道题中有 53 道(53/60) 的前六条结果包含了核查问题所需的完整证据,46 道(46/60) 直接找到了相关的官方或原始来源,并且在其中找到了具体的答案。
横向对比来看,传统 Agent 常用的 Provider D 在完整证据覆盖上只有 34/60,官方或原始来源命中率更是只有 6/60(10%);MolaGPT Web Search 的表现也稳定高于单独调用 Provider A(49/60 与 42/60)。
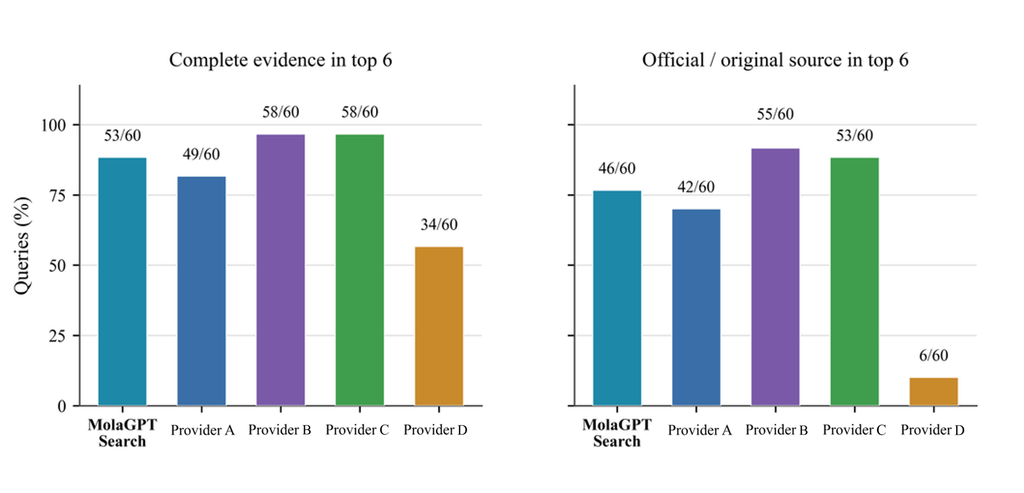
60 道问题,分别统计前六条结果的完整证据与官方或原始来源结果。
财经、论文和技术文档
日常搜索里,有不少问题属于很具体的垂直领域。MolaGPT Web Search 会根据这些差别调度资料来源,财经查询可以找到市场资讯、财经媒体和数据平台;论文查询则可以利用中文文献入口、DOI 和出版平台,继续查找相关研究。
我们内部的 Benchmark 结果显示,首轮领域检索测试里,我们的 MolaGPT Web Search 方案弥合了单一来源的短板,在 4 道财经查询和 8 道论文查询中,前三条结果的目标来源覆盖率均达到 100%(4/4 与 8/8)。
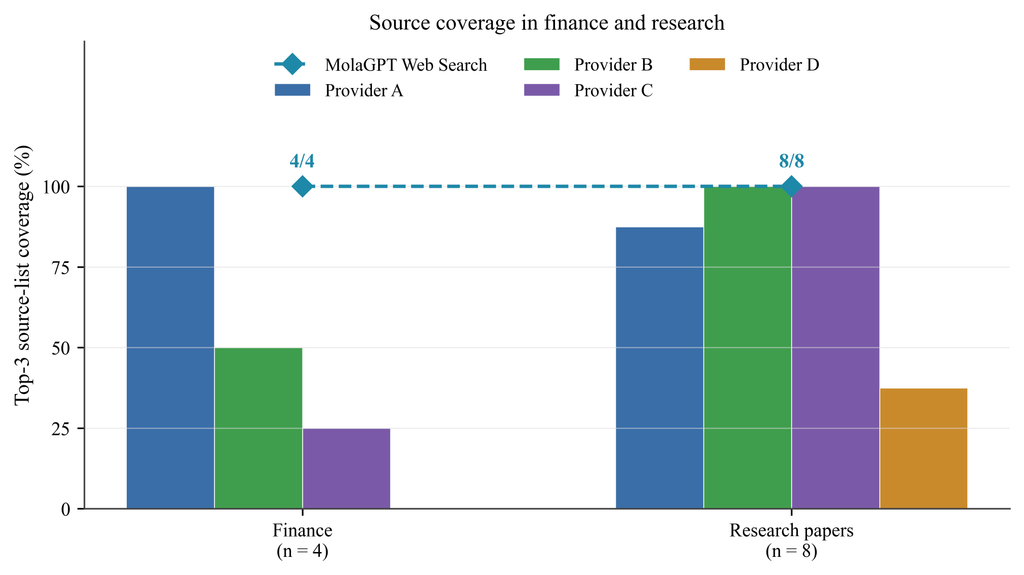
财经 4 道、论文 8 道查询,统计前三条结果的目标来源结果。
在扩展测试中,面对财报量纲换算(如宁德时代年报的“千元”与腾讯报表的“百万元”)和论文发表版本区分等细节,6 道财报与统计问题中有 5 道返回了完整证据,9 道论文与科研规范问题全部找到了可核对关键事实的资料。
而在技术文档领域上,内部 Benchmark 结果显示,首轮 10 道技术查询中,Provider A 和 Provider B 的前三条结果仅命中 1 道官方文档,Provider D 命中 3 道,Provider C 命中 9 道;而 MolaGPT Web Search 全部 10 道(10/10) 都在前三条结果里找到了目标项目的官方文档,为本组最高。
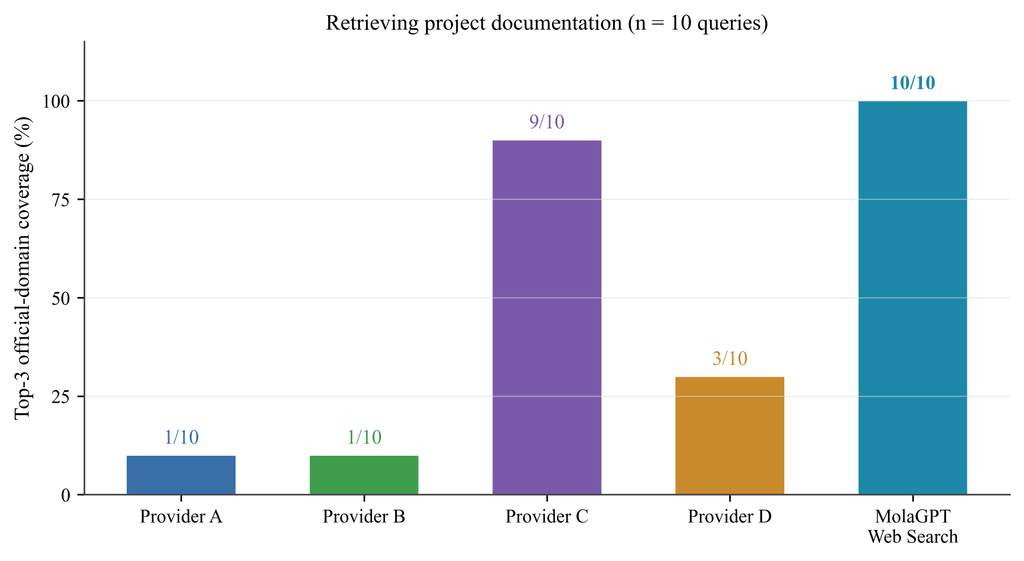
10 道技术查询中,前三条结果的项目官方文档覆盖结果。
扩展后的 16 道技术文档问题(涵盖 Python TaskGroup、PostgreSQL json 与 jsonb、Kubernetes 探针及 Nginx 超时参数等)也全部返回了完整证据。另外补测的 12 道指定网站、版本或时间范围的查询中,MolaGPT 有 9 道找到了符合明确条件的结果,其中 8 道同时提供了完整证据。
除了检索质量,响应速度和成本也是 Agent 工程化中重要的一环,我们内部的 Benchmark 结果显示,Provider C 与 Provider D 虽然响应速度较快,但单次调用成本分别约为 0.036 元和 0.058 元;Provider B 则在中位数延迟上明显偏慢。通过我们的动态路由,MolaGPT Web Search 将端到端中位延迟控制在 910 ms,单次均摊成本压缩至约 0.005 元,这不到 Provider C 的七分之一、Provider D 的十分之一。
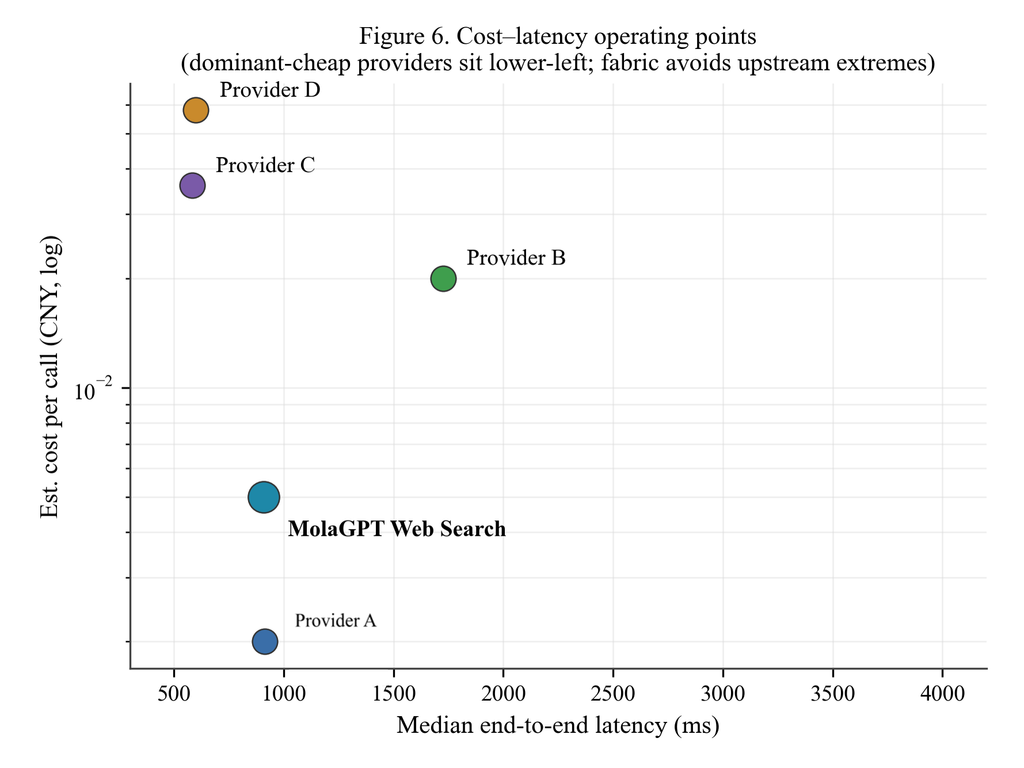
各搜索服务的端到端中位延迟与单次调用预估成本对比(越靠近左下方即代表服务越便宜且延迟越低)。
我将这套搜索能力接入了所有的 MolaGPT 生态,在桌面端和移动端登录 MolaGPT 账号后,自定义模型的本地对话也可以使用 MolaGPT 提供的内置搜索服务。MolaGPT Web Search 将占用少量账号额度。
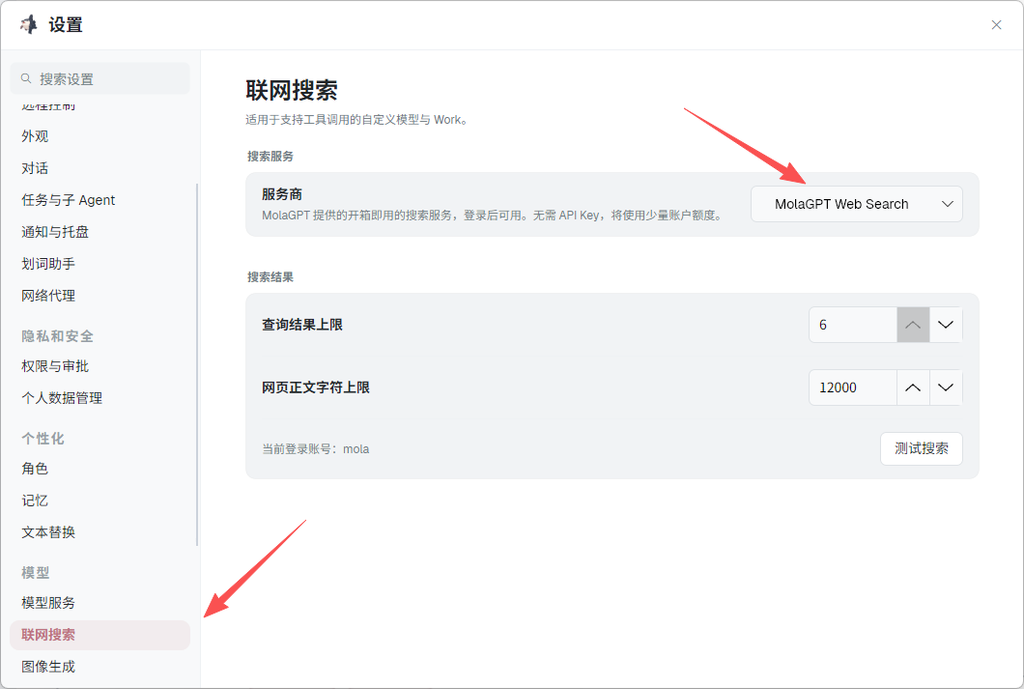
从一张照片开始
如果连搜索词都还没有,也可以直接上传图片,或者发来图片链接。
MolaGPT 的以图搜图可以根据照片寻找相关网页和出处,再利用这些线索继续检索。看到一张风景照,可以查找拍摄地点和相关游记;遇到一张网图,也可以尝试寻找它出现过的页面。
这类问题可以直接围绕图片展开。我把一张建筑照片的链接发给 MolaGPT,请它用以图搜图核实地点,并给出网页依据。它调用了以图搜图工具,识别出照片中的黄鹤楼,并列出了相关页面。
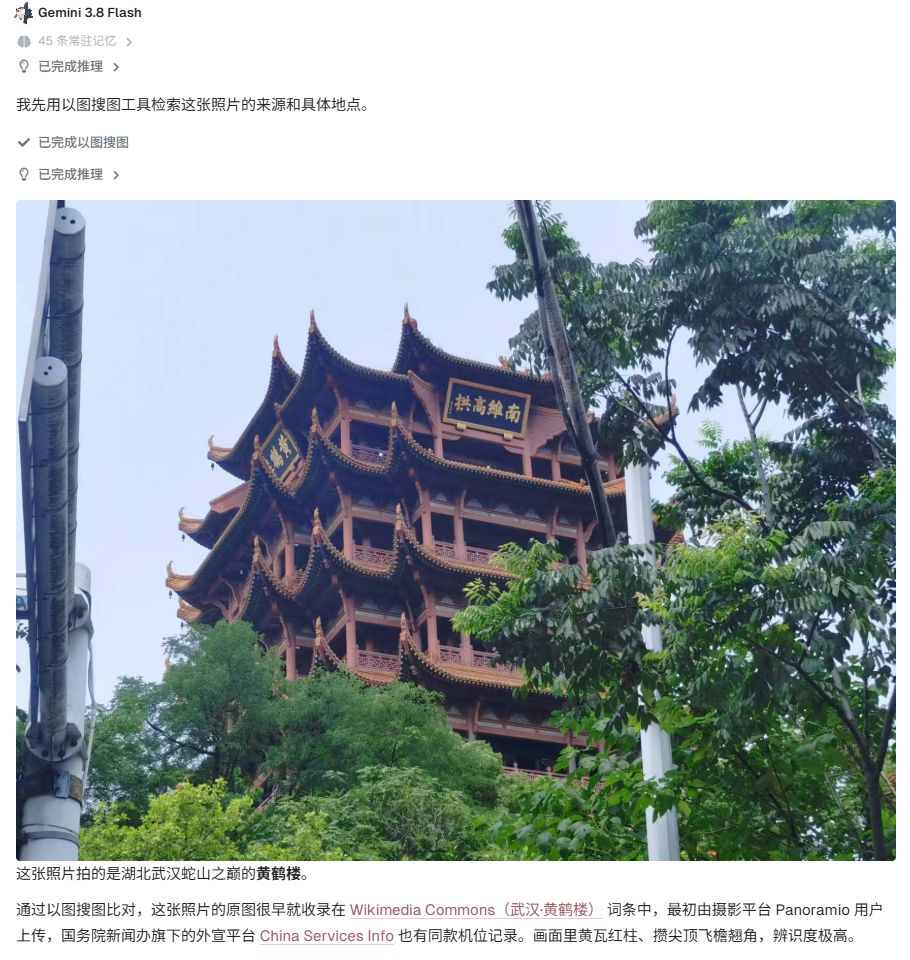
从照片出发,查找地点和相关网页。
拿到线索后,MolaGPT 可以接着阅读相关页面、核对地点,或者寻找更多角度的照片。从上传图片到继续了解图片里的内容,整个过程可以在同一场对话中完成。
Web 端的另外两项更新
继续电脑上的任务
Web 端新增了我的电脑入口,可以查看和继续桌面端的 MolaGPT 会话。
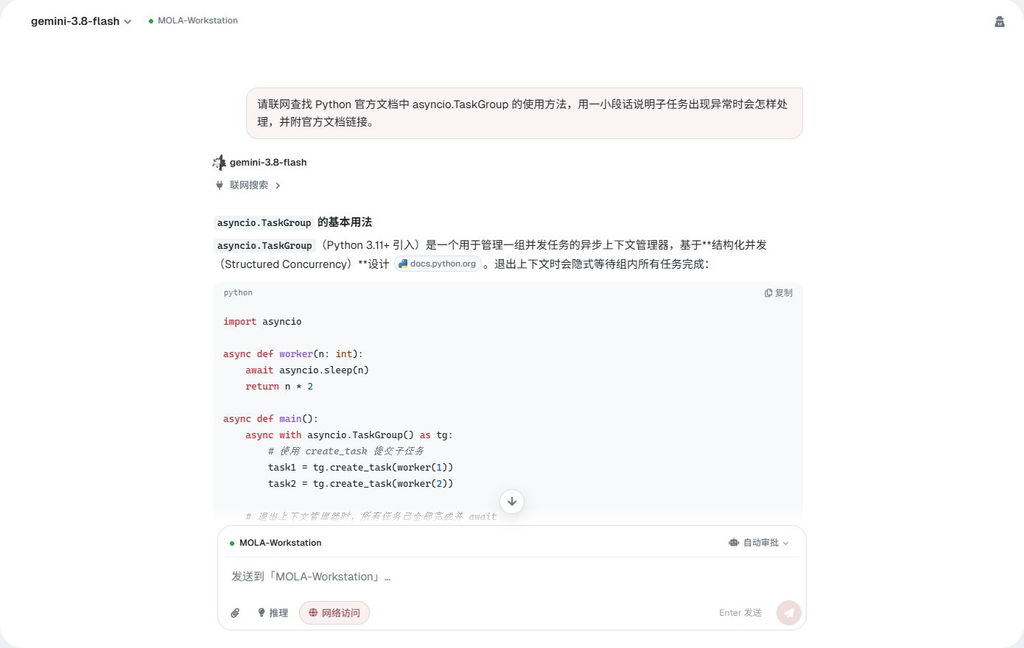
在网页中连接电脑,继续提问并查看工具使用与回答。
Web Chat 上的子 Agent
Web 端也加入了子 Agent 协作。面对可以拆开的任务,MolaGPT 可以让多个子 Agent 同时处理不同部分,再结合它们的结果继续完成回答。
例如,核查一篇讨论 AI 公司估值与现金流的文章时,三个子 Agent 可以分别查找 OpenAI 融资、Anthropic 招股书和信用评级相关资料,主对话再结合它们的结果继续分析。
你可以在侧栏查看各个子任务的进度、使用过的工具和返回的报告,了解任务正在怎样推进。
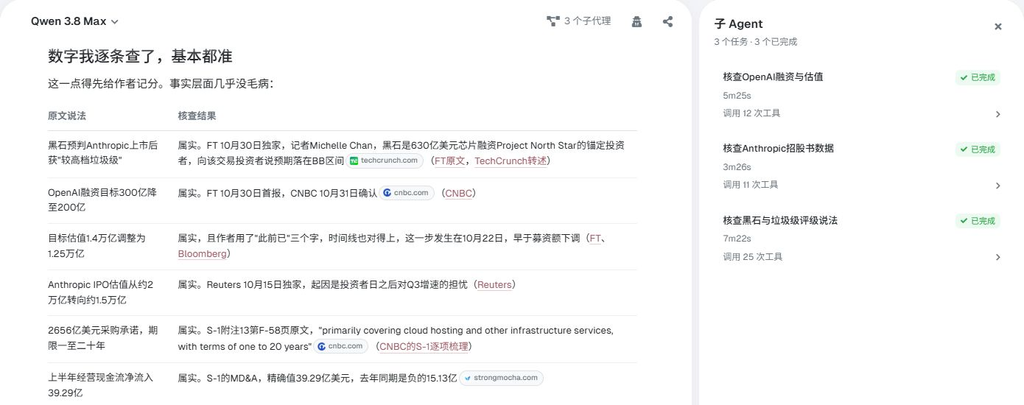
同一篇文章的三个核查任务,以及主对话中的整理结果。
这次更新之后,MolaGPT 利用 MolaGPT Web Search 可以处理更丰富的搜索需求,需要多方面资料时,也可以结合子 Agent 同时查找。
如果你经常用 MolaGPT 查资料、整理攻略,或者根据图片寻找信息,可以试试新的搜索体验。
发表回复